多平台自媒体数据采集工具
MediaCrawler(NanmiCoder/MediaCrawler)是一个功能强大的多平台自媒体数据采集工具,支持小红书、抖音、快手、B 站、微博、贴吧、知乎等主流平台的公开信息抓取。
技术原理:基于 Playwright 浏览器自动化框架登录并保存登录态,利用保留登录态的浏览器上下文环境,通过 JS 表达式获取签名参数——无需 JS 逆向复杂加密算法,大幅降低技术门槛。默认 CDP 模式连接已有 Chrome,复用登录态、Cookie、扩展,降低平台风控检测风险。
版本与获取:实测 67,821 Star(12,940 fork,Python,2023-06 创建、今天仍在更新),仓库 license 标注 NOASSERTION。官方另有商业版 MediaCrawlerPro(断点续爬、多账号+IP 代理池、去 Playwright、AI Agent 支持)。
⚠️ 合规警示:本工具仅供学习和技术研究,严禁用于商业用途或非法目的。作者免责声明明确:爬虫技术仅用于学习和研究,不得用于对其他平台进行大规模爬虫或其他非法行为;国内已有爬虫违法违规案件。请严格遵守《网络安全法》等法律法规与各平台规则,控制采集频率、尊重数据版权与用户隐私;因使用本项目引起的任何法律责任由使用者自行承担。
✨ 核心亮点
- 🖥️ 浏览器自动化:Playwright 登录态缓存,无需 JS 逆向
- 🌐 7 大平台:小红书/抖音/快手/B站/微博/贴吧/知乎
- 🖥️ WebUI 界面:可视化配置、实时日志、数据预览导出
- 💾 多格式存储:CSV/JSON/JSONL/Excel/SQLite/MySQL
🧩 能力速览
| 项目 | 说明 |
|---|---|
| 输入 | 关键词 / 帖子 URL 或 ID / 创作者主页 / 登录方式(扫码等) |
| 适用类型 | 技术学习、研究采集公开信息、数据分析(仅限合规场景) |
| 输出 | 帖子信息、评论(含二级评论)、媒体文件(封面/视频/图文图片)、评论词云图 |
| 语言 / 兼容 | Python 3.11;uv 管理;抖音/知乎需 Node ≥ 16;Chrome ≥ 144(CDP 模式) |
🖼️ 效果图与演示
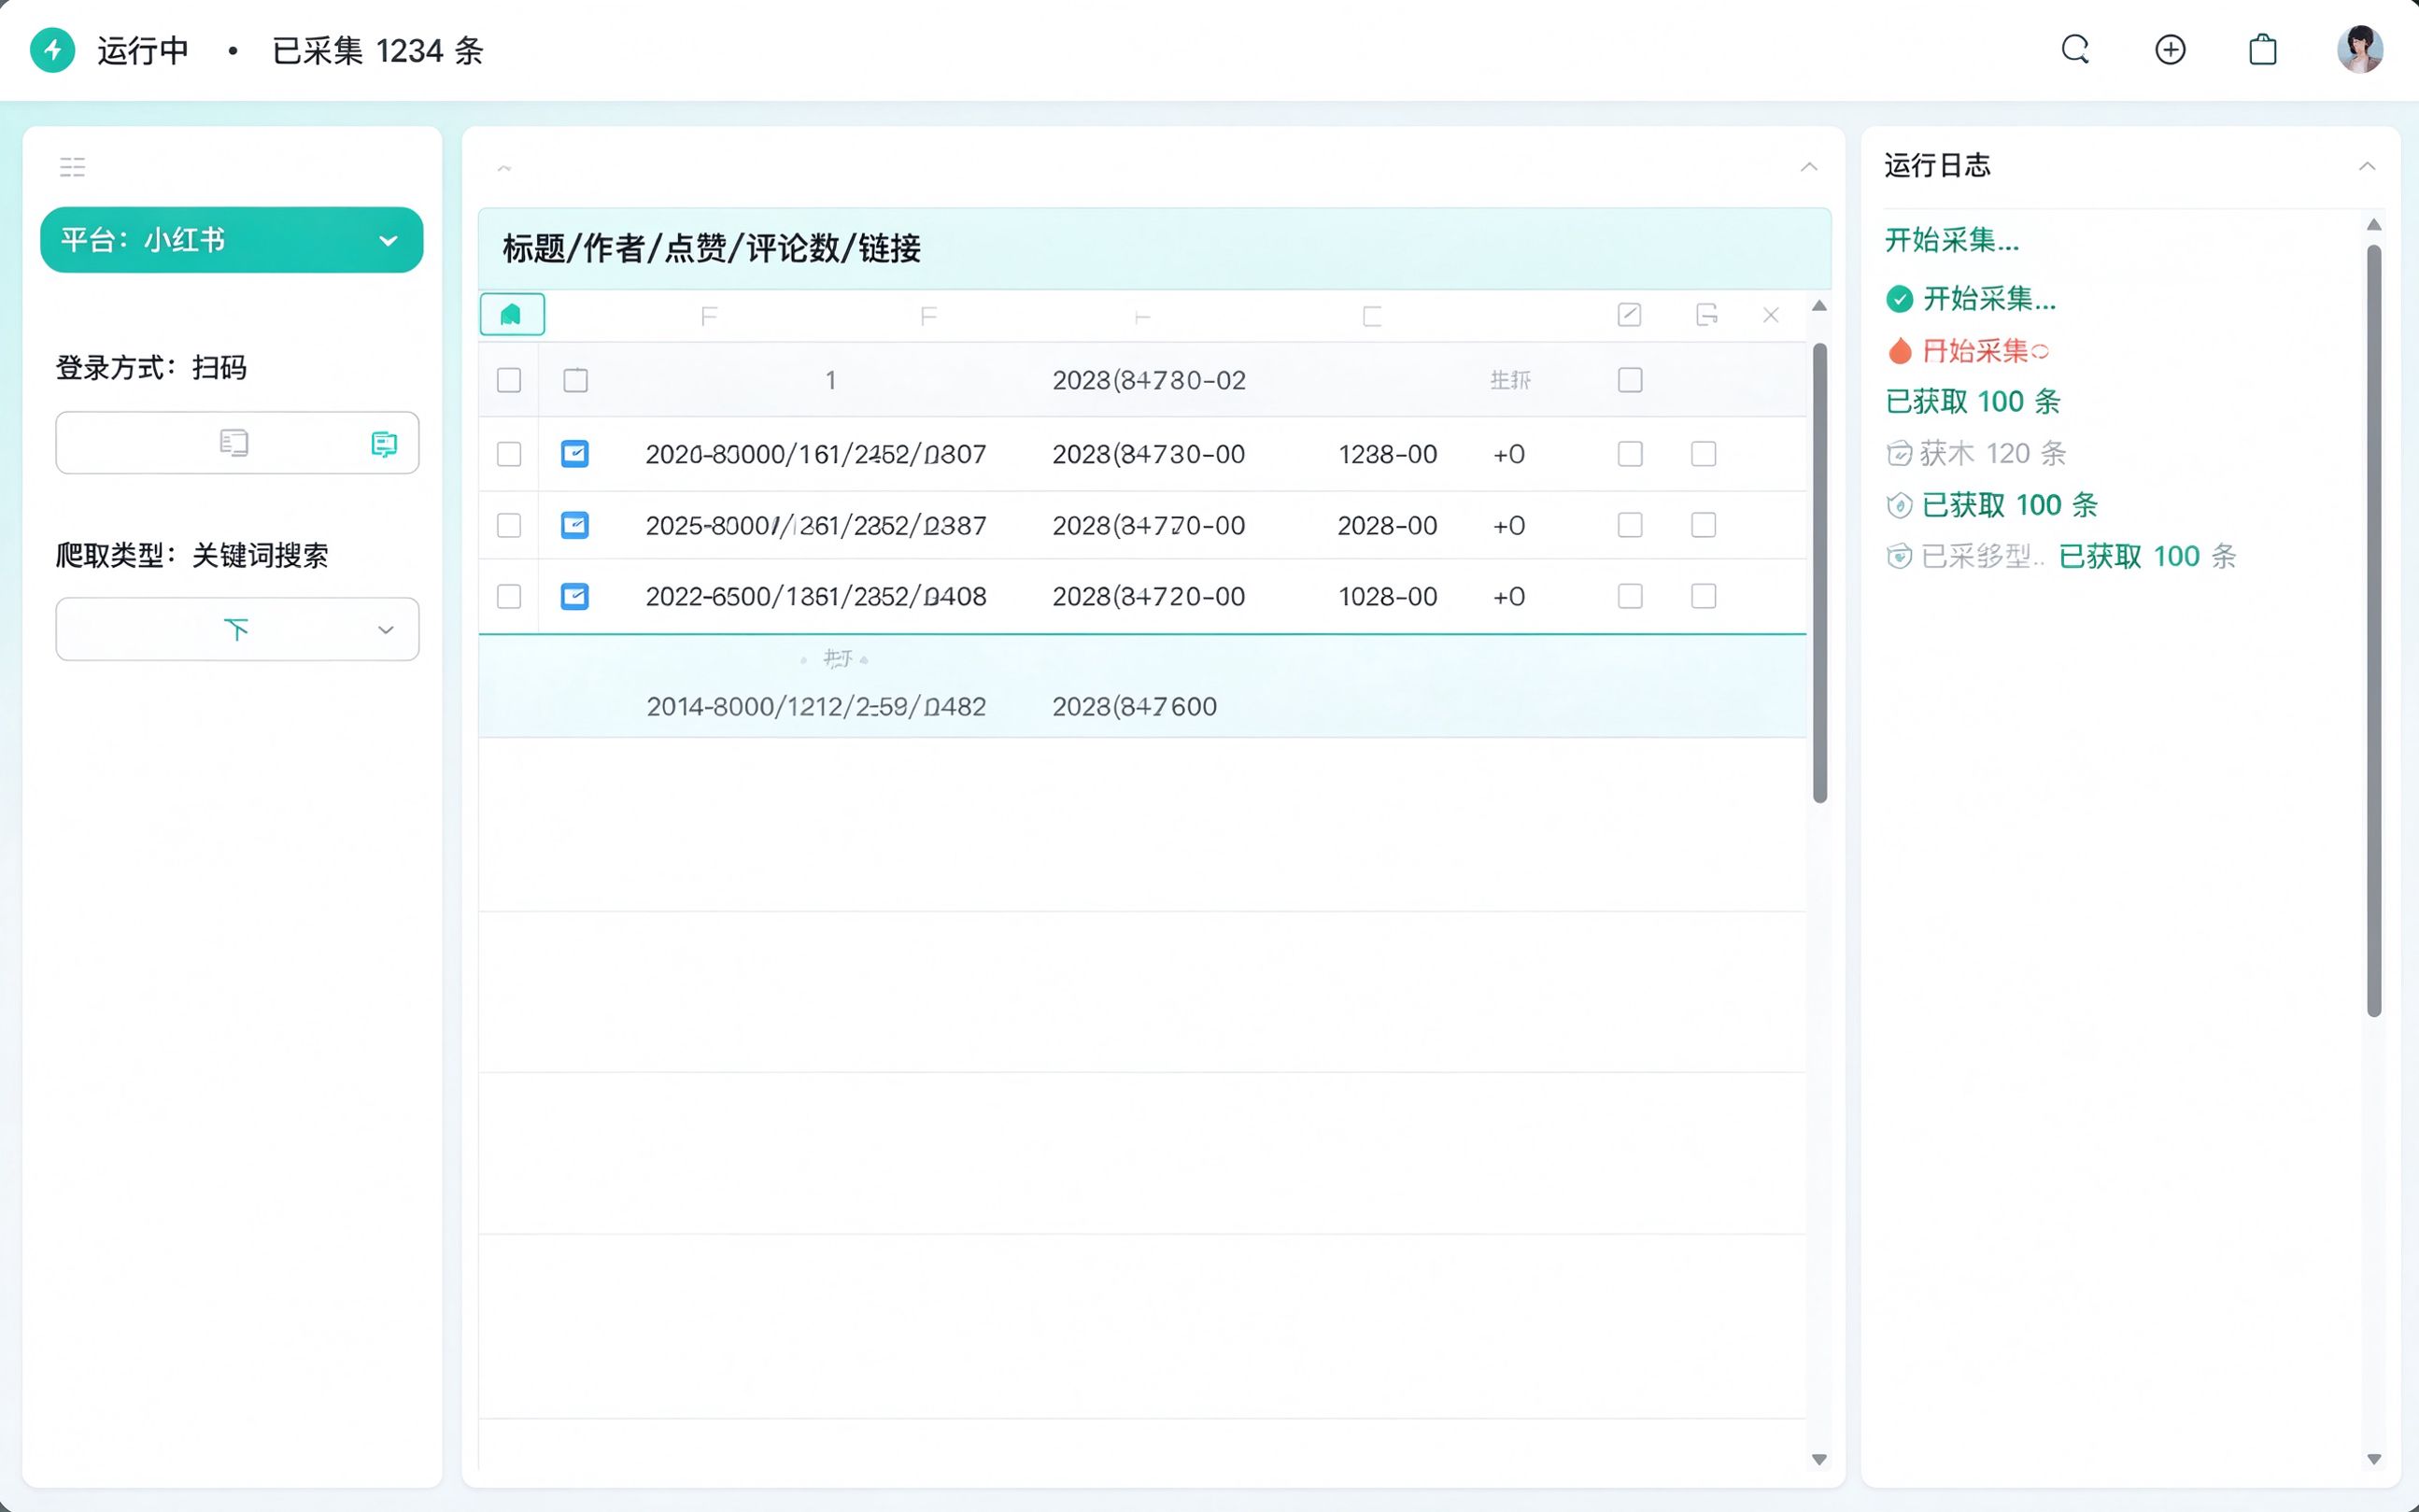
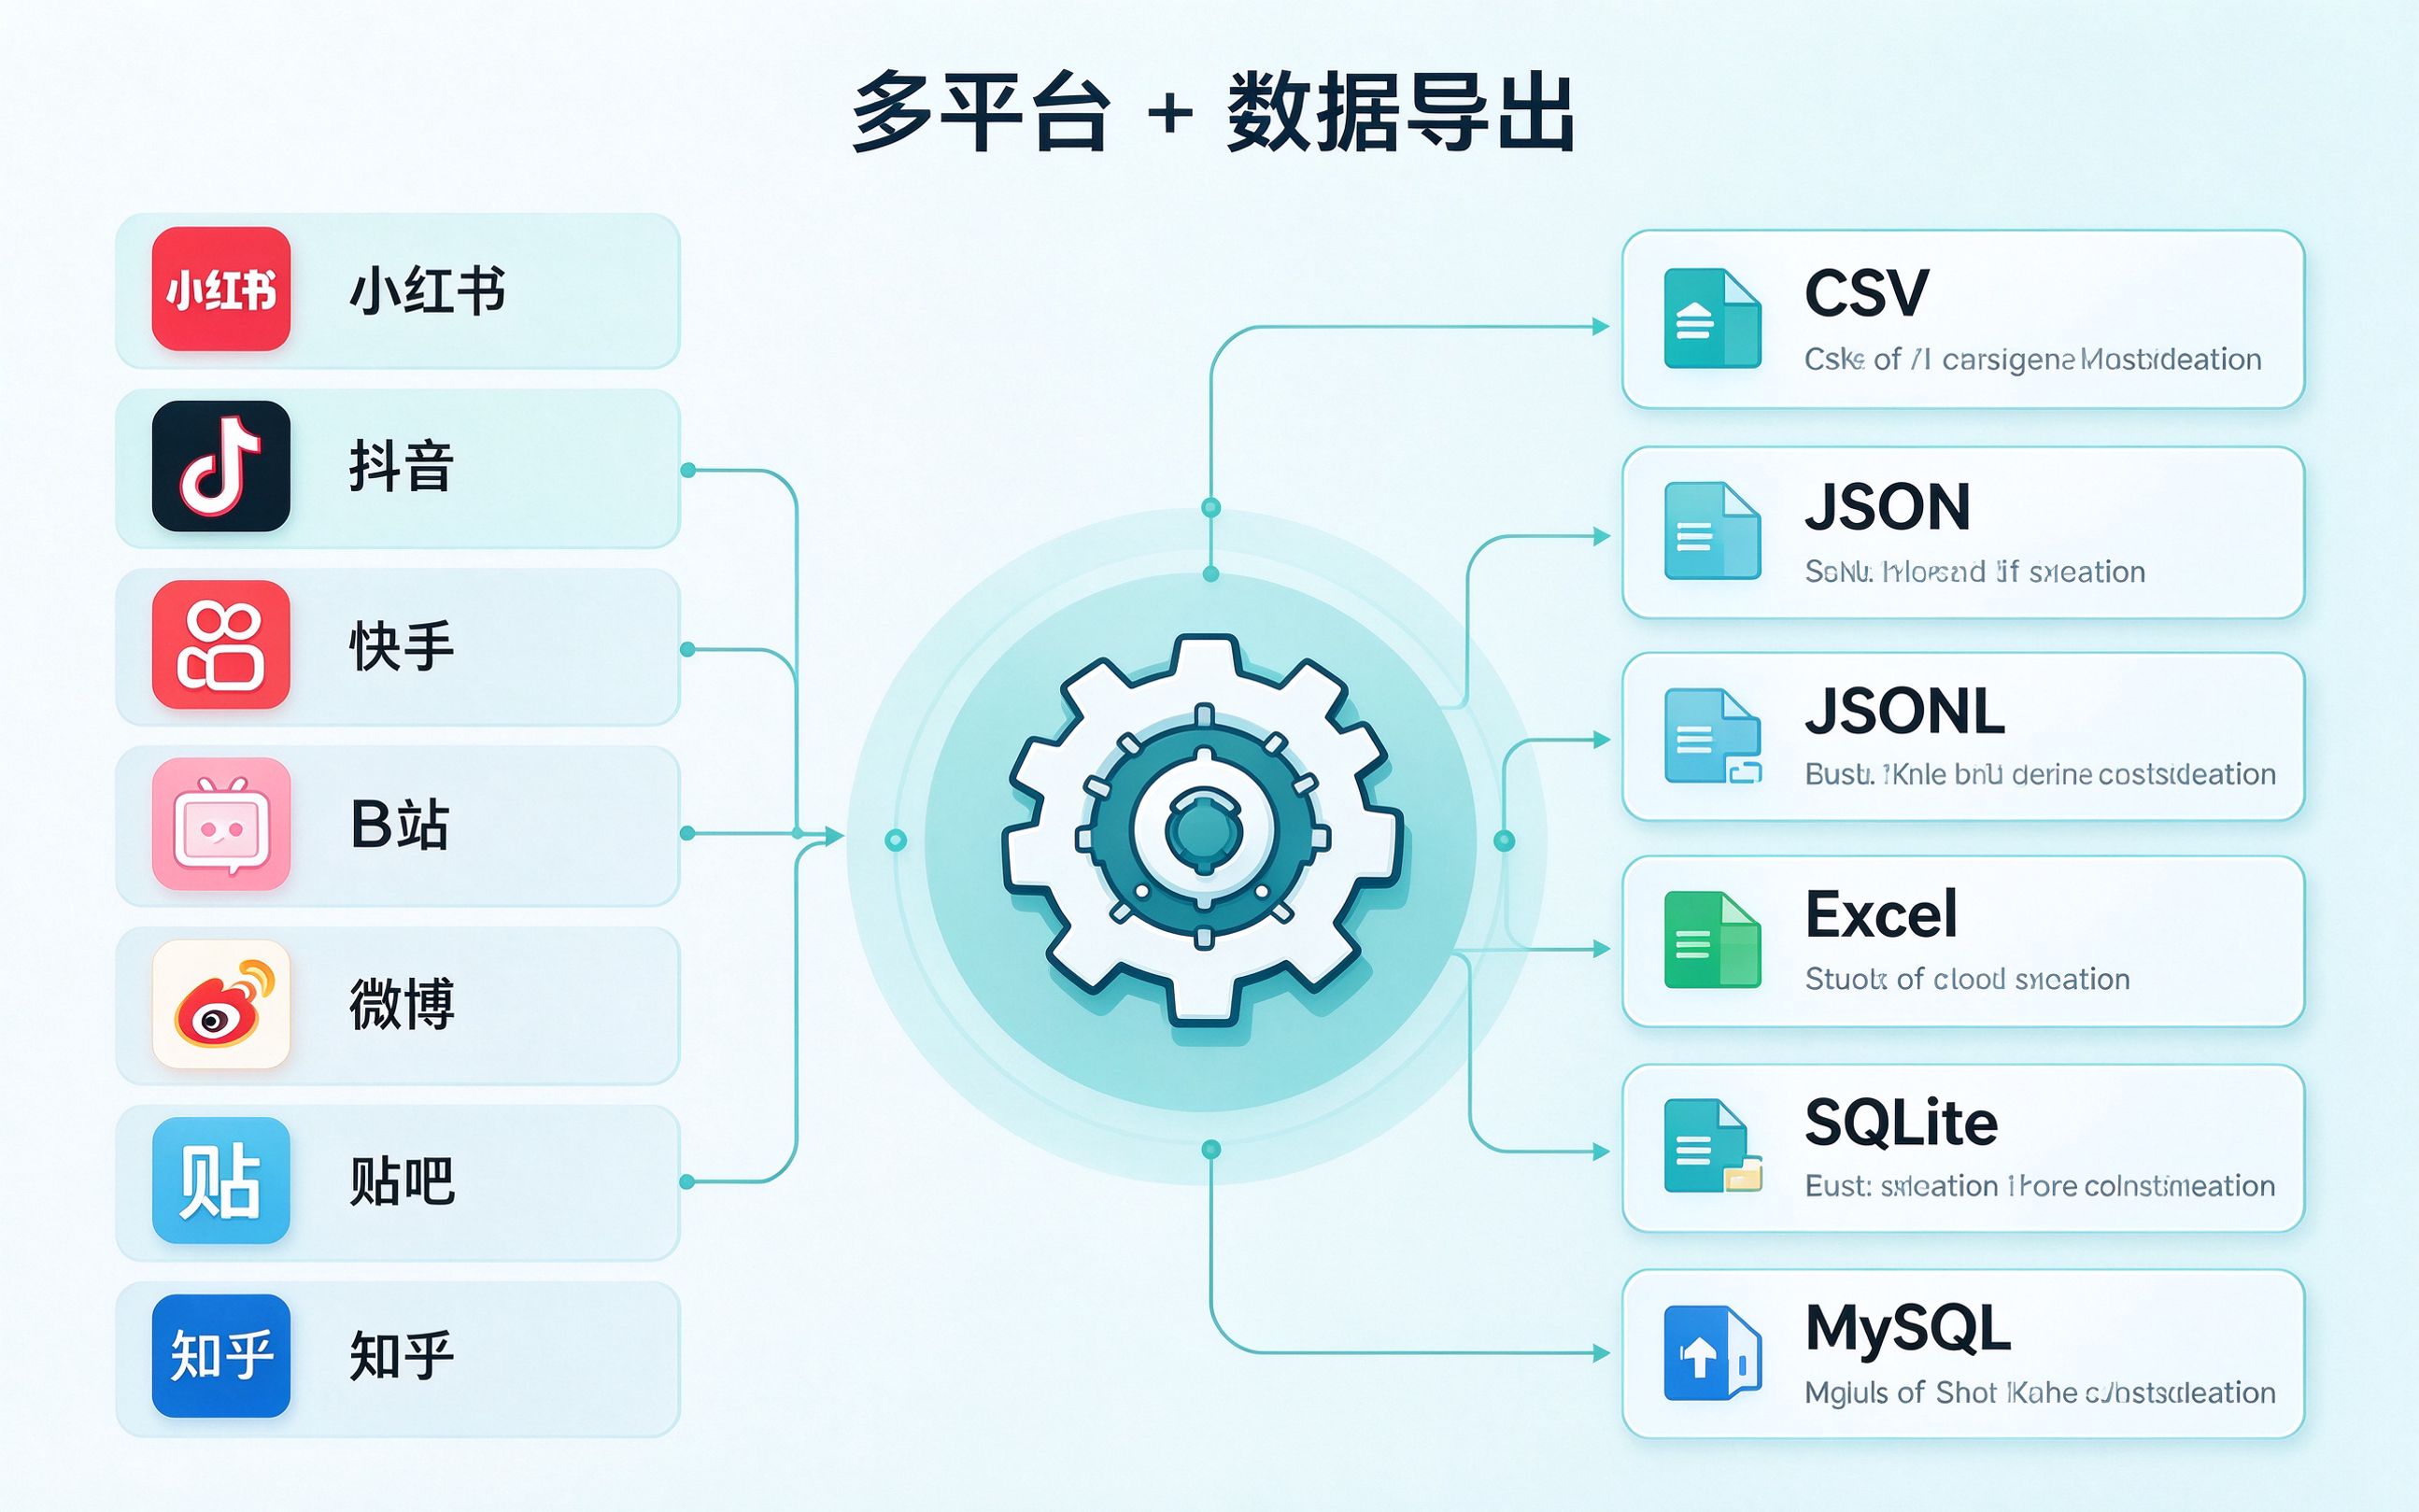
🚀 上手步骤
最快路径:uv 装依赖 + 默认 CDP 模式连已有 Chrome,`uv run main.py` 一条命令跑起来。
① 装 uv 与依赖
先装 uv(Python 包管理器),clone 仓库后一条命令装好依赖。标准 Playwright 模式才需装浏览器驱动。
git clone https://github.com/NanmiCoder/MediaCrawler.git
cd MediaCrawler
uv sync        # 或 uv run main.py --help 自动装依赖
② 配置 Chrome(CDP 模式,推荐)
装 Chrome ≥ 144;地址栏打开 chrome://inspect/#remote-debugging,勾选「Allow remote debugging for this browser instance」,看到 Server running at 127.0.0.1:9222 即可。运行后 Chrome 弹确认框点「接受」(60 秒内)。
③ 运行爬虫
在 config/base_config.py 配置关键词/平台/是否抓评论等(有中文注释)。命令行或扫 APP 二维码登录。
uv run main.py --platform xhs --lt qrcode --type search   # 关键词搜索
uv run main.py --platform xhs --lt qrcode --type detail   # 指定帖子ID
uv run main.py --help
④ (可选)WebUI / 媒体下载
起后端 uvicorn(8080)+ 前端 Vite(5173),访问 localhost:5173 可视化操作;加 --get_media true 下载封面/视频/图,按帖子 ID 落盘 data/ 下。
uv run uvicorn api.main:app --port 8080 --reload   # 终端1
cd webui && npm install && npm run dev            # 终端2 → 打开 localhost:5173
🎯 典型场景
- 📚 技术学习:Playwright 自动化与反爬思路学习
- 🔬 公开数据研究:低频率采集公开信息做分析(须合规)
- 📊 评论词云:对评论做词云/情感可视化作研究
- 🧩 接口学习:浏览器上下文 + JS 表达式取签名
📊 与同类做法比
| 做法 | 结果 |
|---|---|
| 纯 requests + 逆向加密 | 需破解复杂签名算法,门槛高、易失效 |
| 通用爬虫框架 | 针对性强,需自己处理登录态/风控 |
| MediaCrawler | 浏览器自动化 + 登录态缓存,无需 JS 逆向,多平台开箱即用 |
⚠️ 合规提醒:务必控制采集频率、只采集公开信息、不抓取未授权数据、不用于商业/牟利;持续高频采集可能触发平台风控(限流/封号/法律风险)。请先阅读作者免责声明与爬虫违法违规案例后再决定是否使用。
❓ 常见问题
Q:需要 JS 逆向吗?
不需要。核心基于 Playwright 浏览器自动化 + 登录态缓存,通过浏览器上下文里的 JS 表达式获取签名参数,无需破解加密算法。
Q:支持哪些平台?
小红书、抖音、快手、B 站、微博、贴吧、知乎。每平台支持关键词搜索、指定帖子 ID、二级评论、创作者主页、登录态缓存、IP 代理池、评论词云。
Q:用什么数据格式?
CSV、JSON、JSONL、Excel、SQLite、MySQL 均可,详细配置见数据存储指南。
Q:必须装 Chrome 吗?
默认 CDP 模式连已有 Chrome(≥144,复用登录态降低风控),无需装浏览器驱动;也可切 ENABLE_CDP_MODE=False 走标准 Playwright 模式。
Q:能下载视频/封面吗?
能。加 --get_media true 或在 config 设 ENABLE_GET_MEDIA=True,按帖子 ID 聚合落盘 data/ 下;B 站装 ffmpeg 可走 DASH 最高画质合流。
Q:可以用 WebUI 吗?
可以。后端 uvicorn(8080)+ 前端 Vite(5173),可视化配置参数、实时看日志、数据预览导出。
Q:能商用吗?
不能。官方免责声明明确仅供学习研究,禁止商业用途、禁止大规模爬虫/非法行为。国内已有爬虫违法违规案件,使用者自行承担法律责任。
Q:有商业增强版吗?
有 MediaCrawlerPro:断点续爬、多账号 + IP 代理池、去 Playwright、Linux 完整支持、AI Agent 一键安装等,需订阅。
📎 GitHub 搜索 NanmiCoder/MediaCrawler · 关注「AI工具匠」获取更多 AI 工具实操教程